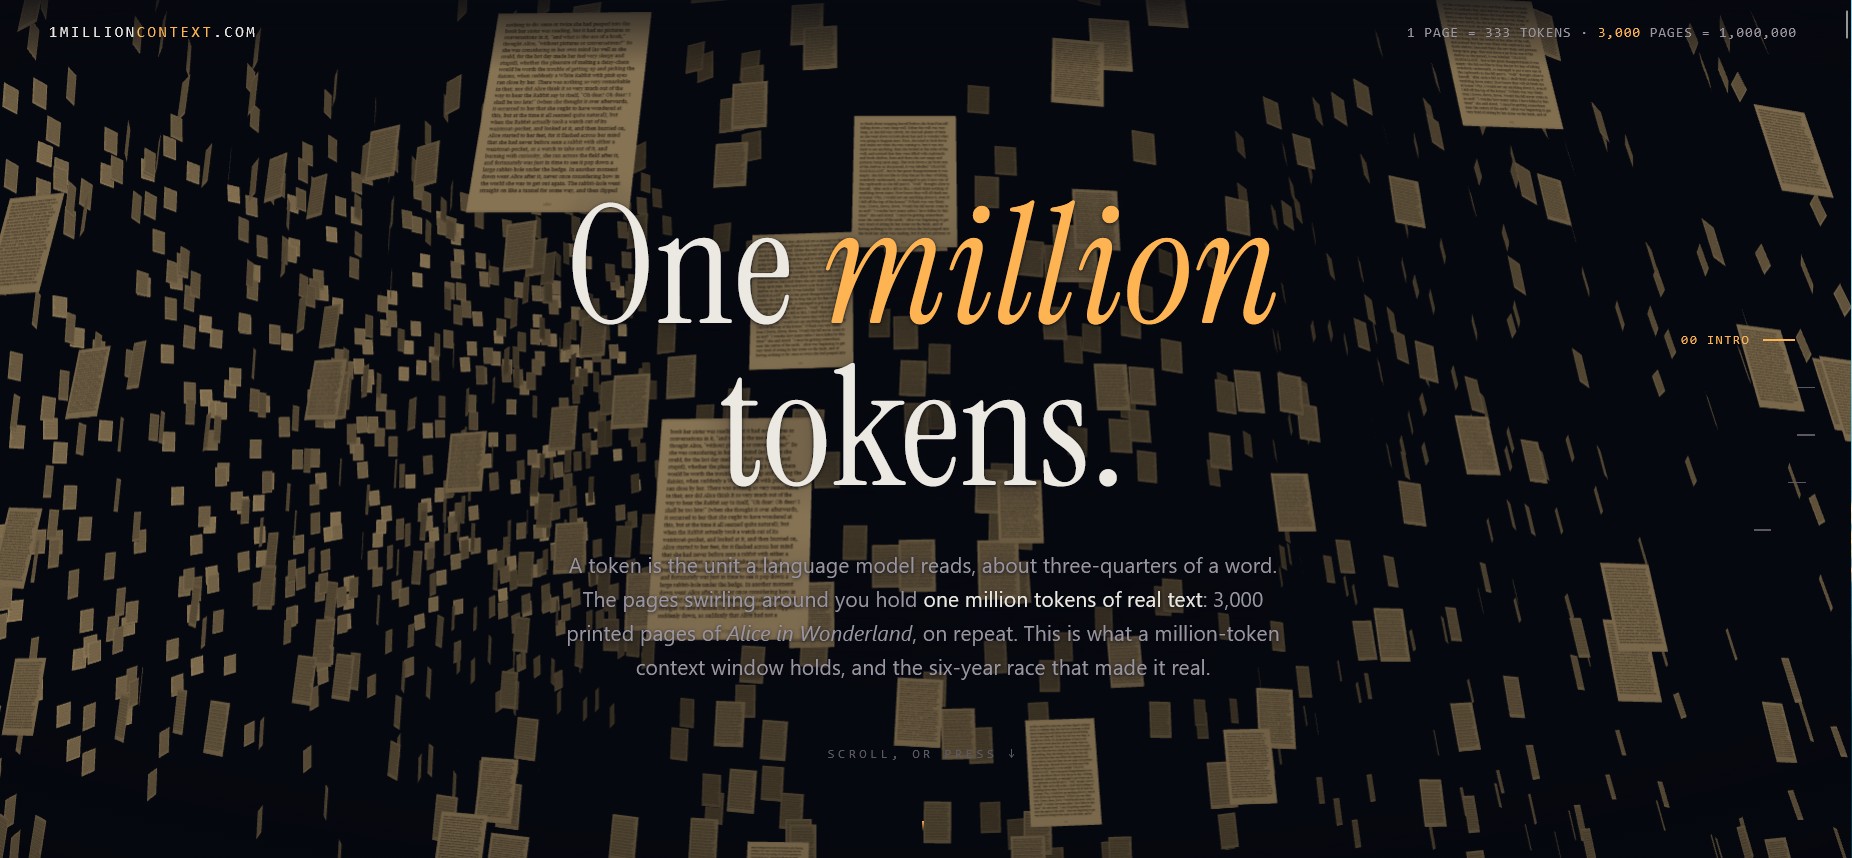
Un million de tokens
Quand on parle Intelligence Artificielle on évoque inévitablement le mot token. Découvrez à travers cette animation promotionnelle, à quoi correspondent un million de tokens.
| Année | Modèle / moteur | Organisation | Contexte maximal approximatif | Particularité |
|---|---|---|---|---|
| 2018 | GPT‑1 | OpenAI | 512 tokens | Premier modèle GPT majeur |
| 2019 | GPT‑2 | OpenAI | 1 024 tokens | Forte amélioration de la génération de texte |
| 2020 | GPT‑3 | OpenAI | 2 048 tokens | 175 milliards de paramètres |
| 2022 | ChatGPT — GPT‑3.5 | OpenAI | 4 096 puis 16 385 tokens | Popularisation des assistants conversationnels |
| 2022 | LaMDA | Environ 8 000 tokens | Modèle spécialisé dans le dialogue | |
| 2023 | GPT‑4 | OpenAI | 8 192 puis 32 768 tokens | Raisonnement et compréhension améliorés |
| 2023 | Claude 1.3 | Anthropic | 100 000 tokens | Première très grande fenêtre de contexte |
| 2023 | Claude 2 | Anthropic | 100 000 tokens | Modèle conversationnel long contexte |
| 2023 | Llama 2 | Meta | 4 096 tokens | Modèle à poids ouverts largement diffusé |
| 2023 | GPT‑4 Turbo | OpenAI | 128 000 tokens | Contexte beaucoup plus long |
| 2023 | Claude 2.1 | Anthropic | 200 000 tokens | Doublement de la fenêtre de Claude |
| 2024 | Gemini 1.5 Pro | 1 à 2 millions de tokens | Très grande capacité documentaire | |
| 2024 | GPT‑4o | OpenAI | 128 000 tokens | Texte, image, audio et interaction temps réel |
| 2024 | Claude 3.5 Sonnet | Anthropic | 200 000 tokens | Raisonnement et programmation améliorés |
| 2024 | Llama 3.1 | Meta | 128 000 tokens | Modèle ouvert avec long contexte |
| 2024 | Mistral Large 2 | Mistral AI | 128 000 tokens | Modèle européen performant en texte et code |
| 2025 | GPT‑4.1 | OpenAI | 1 000 000 tokens | Long contexte et programmation |
| 2025 | Llama 4 Scout | Meta | Jusqu’à 10 000 000 tokens | Très grande fenêtre de contexte |
| 2025 | Llama 4 Maverick | Meta | Environ 1 000 000 tokens | Modèle multimodal à poids ouverts |
| 2025 | DeepSeek‑R1 | DeepSeek | Environ 128 000 tokens | Modèle orienté raisonnement |
| 2025 | Mistral Large 3 | Mistral AI | 256 000 tokens | Modèle multimodal à poids ouverts |
| 2026 | Modèles de nouvelle génération | Plusieurs acteurs | Jusqu’à environ 1 000 000 tokens | Modèles orientés agents, code et raisonnement |
Les jalons les plus importants sont le passage de 2 048 tokens pour GPT‑3 en 2020 à 128 000 tokens pour GPT‑4 Turbo en 2023, puis à 1 à 2 millions de tokens avec Gemini 1.5 en 2024. Les modèles ouverts ont ensuite fortement progressé, notamment avec Llama 4 Scout et sa fenêtre annoncée jusqu’à 10 millions de tokens. Ce n’est pas pour autant que ces modèles sont plus intelligents. Cela représente un marqueur pour le volume de texte qui peut être utilisé par un moteur.
Source : Wikipedia, LLM Context Window Growth Timeline